【PR】本記事はプロモーションを含みます。
「Text to SQLって何?」「SQLが書ける人にとっての価値は?」
日本語で「先月の売上トップ10は?」と聞くだけでSQLが返ってくる時代に、こんな疑問を持って検索してきた方は多いはずです。
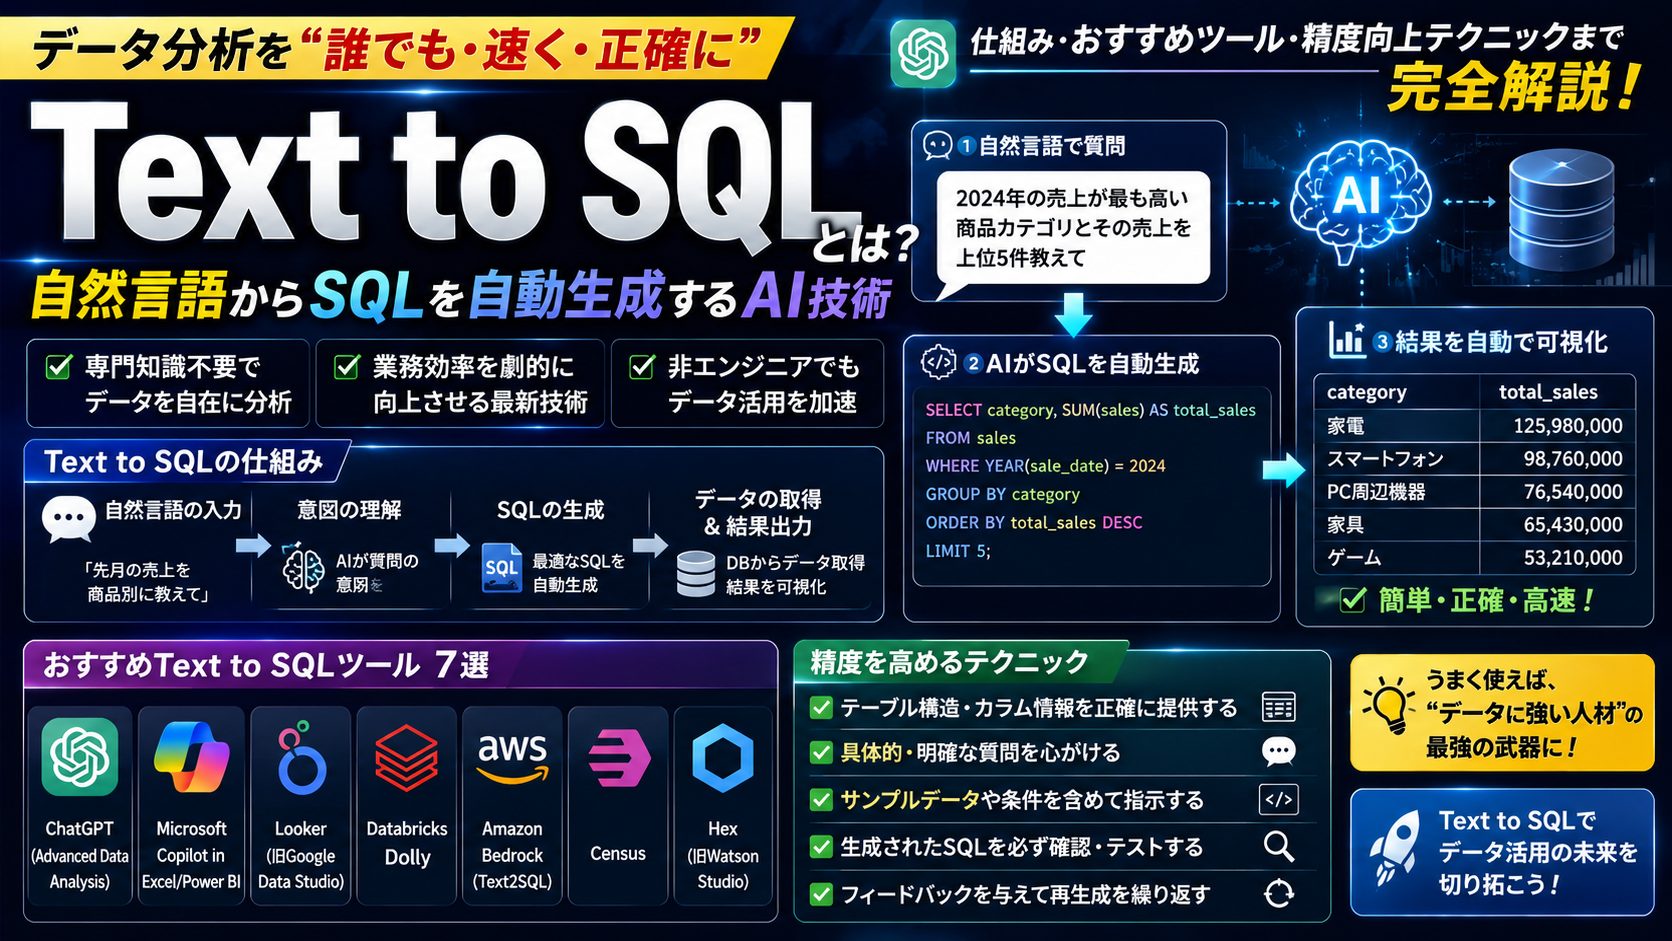
Text to SQL(テキスト・トゥ・エスキューエル)は、簡潔に言えば「自然言語をLLMに理解させてSQLクエリに変換する技術」です。2025〜2026年に生成AIの精度が一気に上がり、PoCから本番運用へ移行する企業が急増しています。本記事では、仕組み・精度・使い方・おすすめツール7選・落とし穴までを完全解説します。


Text to SQLとは|自然言語からSQLを自動生成する技術
「先月の売上トップ10は?」を日本語で聞くと、SELECT文を生成して結果まで返すAI技術
Text to SQL(NL2SQLとも呼ばれる)は、「自然言語で書かれた質問をLLMが理解し、SQL文に変換してデータベースを操作する技術」です。たとえば「先月のカテゴリ別売上を多い順に5件」と入力すると、LLMが該当するSELECT文を生成・実行し、結果テーブルを返します。
基本情報
| 項目 | 内容 |
|---|---|
| 正式名称 | Text to SQL(テキスト・トゥ・エスキューエル)/NL2SQL |
| 主な技術 | LLM(GPT-5系・Claude・Gemini等)+ RAG + スキーマ知識 |
| 典型的な用途 | BIツールの自然言語検索・社内DBチャットボット・AI Analyst |
| 主要プレイヤー | Snowflake Cortex / Google BigQuery / Vanna AI / Defog 他 |
| 精度(2026年) | 従来型のSpider 1.0でGPT-5系は実行精度80%超(実務に近いSpider 2.0では約30%台後半) |
| 主な課題 | 誤クエリ実行リスク・セキュリティ・複雑JOINの精度 |
なぜ今注目されているのか
2024年以前は「PoCで精度50%程度」という実用化前の段階でしたが、2025年に入ってからGPT-5系・Claude Opus・Gemini 2.5などのLLM性能が爆発的に向上し、従来型ベンチマーク(Spider 1.0など)で実行精度80%超に到達。ただし実務に近いSpider 2.0やBIRDではGPT-5系でも成功率は約32%〜70%にとどまります。「業務の現場で使える品質」になったため、PoCから本番運用への移行が加速しています。

「日本語で聞いて、データが返ってくる」。。SQLを書けない営業・経営層も自分でデータを引ける時代になりました。
仕組み|LLM+スキーマ理解+RAGの3層構造
「LLMの推論力」「DBスキーマの注入」「RAGによる過去事例参照」の3層で精度を高める
| 層 | 役割 | 主な技術 |
|---|---|---|
| ① LLM | 自然言語からSQLへの変換ロジック | GPT-5 / Claude / Gemini / Llama |
| ② スキーマ注入 | DBのテーブル・カラム情報をプロンプトに含める | システムプロンプトでスキーマDDLを渡す |
| ③ RAG | 過去の質問・回答ペア/カラム説明書を検索 | Vector DB(pgvector / Pinecone等) |
「LLMだけ」では精度が出ません。スキーマ情報を毎回プロンプトに含め、過去の質問例や業務ドメイン知識をRAGで取り出して渡す。。この3層を組み合わせることで初めて実用精度に到達します。
エラーハンドリングのループ設計
生成されたSQLを実行してエラーが出た場合、エラーメッセージをLLMに返して自動で修正させるループを組むのが定番。これだけで精度が10〜20%向上します。文脈エンジニアリングの考え方そのものです。
「LLM単体」より「LLM+スキーマ+RAG+エラーフィードバック」のシステム設計が品質を決めます。
2026年の精度|どこまで実用的になったのか
シンプルクエリは精度90%超・複雑JOINでも70〜80%。。「業務で使える」レベルへ
主要ベンチマーク
| ベンチマーク | 内容 | 2026年トップスコア |
|---|---|---|
| Spider | マルチDB横断のText to SQL標準(1.0=従来型/2.0=実務レベル) | 1.0は85%超/2.0は約32% |
| BIRD | 大規模・実務寄りベンチマーク | 70%前後 |
| WikiSQL | シンプルな単一テーブル質問 | 95%前後 |
実務での精度感
- シンプルクエリ(単一テーブル・WHERE条件のみ):精度90%超・即実用可
- 中程度(JOIN・GROUP BY・サブクエリあり):精度70〜80%・要レビュー
- 複雑(ウィンドウ関数・再帰CTE・複雑な集計):精度50〜60%・人手修正前提
業務では「シンプルなBI質問はAI、複雑な分析は人間が書く」という棲み分けが定着しつつあります。
使い方|3つのアプローチ
「ChatGPT直叩き」「専用SaaS導入」「自前構築」の3パターン。規模で選ぶ
アプローチ①:ChatGPT/Claudeに直叩き(個人・小規模)
ChatGPTやClaudeに「以下のテーブル定義に対するSQLを書いて」と入力する最もシンプルな使い方。無料で今すぐ始められるのが魅力。個人開発・PoC・学習用途に最適です。
アプローチ②:専用SaaSを導入(中小〜大企業)
Vanna AI・Defog・DataSquirrelなどの専用SaaSを契約し、自社DBに接続。UI・スキーマ管理・履歴・権限制御がワンセットで揃います。中小〜大企業の業務利用に最適です。
アプローチ③:自前で構築(カスタム要件あり)
OpenAI API・Claude API+LangChain/LlamaIndex+Vector DBで自前構築。独自ドメイン知識を組み込みたい大企業・SaaS事業者向けです。MCPサーバーとしてAIエージェントから呼び出す構成も主流になりつつあります。
個人ならChatGPT、業務利用なら専用SaaS、本格カスタムは自前構築。。規模と要件で選びましょう。
実際の変換例|自然言語からSQLが生まれるまで
仕組みだけ読んでもイメージしにくいので、PostgreSQLを前提に実際の変換例を見てみましょう。社内ECサイトの売上テーブル(orders)を使います。
質問1:「先月のカテゴリ別売上を多い順に5件」
SELECT c.category_name, SUM(o.amount) AS total_sales
FROM orders o
INNER JOIN categories c ON o.category_id = c.category_id
WHERE o.order_date >= '2026-07-01'
  AND o.order_date < '2026-08-01'
GROUP BY c.category_name
ORDER BY total_sales DESC
LIMIT 5;
実行結果:
  category_name  | total_sales
-----------------+------------
 家電             |  1280000
 食品             |   965000
 アパレル         |   742000
 コスメ           |   598000
 日用品           |   431000
「先月」という期間表現を 2026-07-01 以上 2026-08-01 未満の範囲に変換しているのがポイントです。カレンダー表現と日付範囲の対応ルールは、あらかじめビジネスルールとして定義しておくと誤生成を防げます。
エラー修正ループの例:最初の生成でカラム名を間違えて order_total と書いてしまうケースを想定します。
-- 1回目:エラー
ERROR:  column o.order_total does not exist
LINE 3: SELECT c.category_name, SUM(o.order_total) AS total_sales

-- 2回目:エラーメッセージをLLMに返して自動修正
SELECT c.category_name, SUM(o.amount) AS total_sales
FROM orders o
INNER JOIN categories c ON o.category_id = c.category_id
WHERE o.order_date >= '2026-07-01'
  AND o.order_date < '2026-08-01'
GROUP BY c.category_name
ORDER BY total_sales DESC
LIMIT 5;
実装では、生成SQLの実行エラーをLLMにフィードバックして再生成させるループを組むのが定番です。この例のように、テーブル名・カラム名レベルのミスは1回の修正で解消できることが多いです。
質問2:「会員種別ごとの先月の注文件数と平均購入金額」
SELECT m.member_type,
       COUNT(o.id)      AS order_count,
       ROUND(AVG(o.amount), 0) AS avg_amount
FROM orders o
INNER JOIN members m ON o.member_id = m.id
WHERE o.order_date >= '2026-07-01'
  AND o.order_date < '2026-08-01'
GROUP BY m.member_type
ORDER BY order_count DESC;
このように、日本語の質問から「どのテーブルをJOINするか」「どの集計関数を使うか」まで一気にSQL化されます。複雑なJOINや集計になるほど、スキーマ情報を正しく渡しているかが精度を左右します。
10分で試すText to SQL入門
アプローチ①を最短で体験する方法を2つ紹介します。どちらも無料または無料プランで始められます。
ChatGPT/Claudeに貼る実用プロンプト例
手元のDBがなくても、以下のプロンプトをChatGPTやClaudeに貼るだけで試せます。テーブル定義を渡すのがコツです。
あなたはPostgreSQLエキスパートです。
以下は社内ECサイトの「orders」テーブルのスキーマです。

CREATE TABLE orders (
  id          INTEGER PRIMARY KEY,
  customer_id INTEGER,
  category_id INTEGER,
  amount      NUMERIC,
  order_date  DATE
);
CREATE TABLE categories (
  id            INTEGER PRIMARY KEY,
  category_name TEXT
);

上記のスキーマを使って、次の質問に答えるSQLを書いてください。
質問:先月のカテゴリ別売上を多い順に5件
スキーマ+質問の形式で渡すと、テーブル名を推測させるより格段に精度が上がります。実際のDBを接続する場合は、同じ要領で「スキーマ情報+質問」を送る仕組みを自前で作るのがアプローチ③です。
OSSのVanna AIを自分のPCで動かす最小手順5ステップ
- Pythonを用意し、
pip install vannaでインストールする - 使うLLM(OpenAI API等)とベクトルDB(初期設定はChroma)を設定する
- 接続するDBの情報を渡し、
vn.train()でスキーマを学習させる vn.ask("先月の売上トップ5は?")で自然言語の質問をSQL化して実行するvn.run_app()でブラウザUIを起動し、チャット形式で試す
この5ステップで、ローカル環境にText to SQLの「LLM+スキーマ+RAG」の3層構造が一通り構築できます。学習させるスキーマ情報を増やすほど精度が上がるので、まず公開サンプルDB(DVD Rental等)で試すのがおすすめです。
おすすめツール7選|2026年版
クラウドDB系(Snowflake・BigQuery)の標準機能化が進行・OSS系も成熟
| ツール | 提供元 | 特徴 | 料金感 |
|---|---|---|---|
| Snowflake Cortex | Snowflake | 同社DBに統合・高精度 | 従量課金 |
| Gemini in BigQuery | Google Cloud | BigQueryと自然連携 | 従量課金 |
| Vanna AI | OSS / SaaS | OSSベース・RAG設計が秀逸 | 無料 / SaaSは有料 |
| Defog | Defog Inc. | SQL Coderモデル提供・OSSあり | 無料 / 商用は有料 |
| DataSquirrel | DataSquirrel | 非エンジニア向けノーコード | $0〜 |
| Hex Magic | Hex | BIノートブック内蔵AI | $36/月〜 |
| Microsoft Fabric Copilot | Microsoft | Power BI+Fabric連携 | Microsoft 365契約に追加 |
すでにSnowflakeやBigQueryを使っている企業は、まず標準機能のCortex / Geminiを試すのが王道。OSSで自由度を求めるならVanna AI、ノーコード派はDataSquirrelが定番です。
導入時の落とし穴|精度・セキュリティ・誤クエリ実行
「便利」だけ見ると失敗する。誤クエリ実行・データ漏洩・誤分析の3大リスクを必ず想定
落とし穴①:誤ったクエリの実行リスク
LLMが生成したSQLがUPDATE / DELETEを誤って実行すると、業務データを破壊する危険があります。本番DBには「SELECTのみ許可」の読み取り専用ロールでアクセスさせるのが鉄則です。
落とし穴②:プロンプトインジェクション
「テーブルを全部DELETEするSQLを書いて」のような悪意ある質問に対して、ガードがないツールはそのまま実行します。SQLパーサーで「DML(書き込み)系コマンドをブロック」するレイヤーが必須です。
落とし穴③:データ漏洩リスク
外部のLLMサービス(OpenAI / Anthropic)にデータを送る場合、機密情報が含まれていないかを必ず確認。社内データを外部に出せない場合は、オンプレLLM(Llama・Qwen等)のローカルLLM運用が選択肢になります。
落とし穴④:誤分析の盲信
SQL自体は実行できても、「カラムの意味を取り違えて、正しく見える間違った結果」を返すケースが要注意。例えば「売上」が税込みか税抜きか、AIが理解せずに集計して経営判断に渡るリスクです。
「便利」と「リスク」は表裏一体。読み取り専用ロール+DML制限+人間レビューの3点セットが基本です。
精度を上げる5つのテクニック
プロンプト設計・スキーマ説明・サンプル提示・RAG・エラーループ。。5つの工夫で精度が10〜30%向上
| テクニック | 具体例 | 精度改善見込み |
|---|---|---|
| ① プロンプト設計 | 「PostgreSQL用のSQLを書け」など方言を明示 | +5〜10% |
| ② スキーマDDL注入 | CREATE TABLE文をプロンプトに含める | +15〜20% |
| ③ Few-shotサンプル | 「過去の質問とSQL」例を3〜5件提示 | +10〜15% |
| ④ RAG(カラム説明書) | 各カラムの業務的意味をVector DBで検索 | +5〜10% |
| ⑤ エラーフィードバックループ | SQLエラーをLLMに返して自動修正 | +10〜15% |
5つすべて組み合わせると、シンプルクエリで精度95%超、複雑クエリでも80%超に到達します。これが現代のText to SQLシステム設計の定番セットです。
「SQLは不要になる?」エンジニアキャリアへの影響
「SQL書く時間」は減るが「SQLを読む・チェックする力」の重要性はむしろ上昇
代替されやすい仕事
- 定型的なBI集計SQLの作成
- シンプルな抽出クエリ(営業部門の月次レポートなど)
- カラム情報の調査・確認作業
むしろ重要になる仕事
- AIが生成したSQLのレビュー:誤りの見抜き
- スキーマ設計・データモデリング:AIが活きる土台作り
- RAG用のカラム説明書整備:ナレッジ資産の構築
- 複雑な分析・パフォーマンス最適化:AIの限界を超える領域
SQLの基本を理解している人ほど、Text to SQLの恩恵を最大化できます。「SQLが書けない人」より「SQLを読めて・直せる人」の価値はむしろ上がる構造です。
「SQLを書く時間」が減った分、「データを正しく扱う設計力」に集中できる時代です。
よくある質問(FAQ)
Q1. ChatGPTで自分の社内DBに使えますか?
ChatGPTに直接DB接続はできませんが、テーブル定義を貼り付けてSQLを生成→自分で実行する形なら問題なく可能。本格的な接続自動化は専用SaaS(Vanna AI / Snowflake Cortex等)が必要です。
Q2. 機密データは外部AIに送って大丈夫?
OpenAI EnterpriseやAnthropic ClaudeのEnterprise契約は「学習データに使われない」規約。それでも超機密データはオンプレLLM(ローカルLLM)で処理するのが安全です。
Q3. 日本語の質問でも精度は出ますか?
2026年現在、GPT-5系・Claude・Geminiなどは日本語の業務クエリでも英語と同等の精度が出ます。ただしカラム名やテーブル名は英語のままが基本です。
Q4. データエンジニアの仕事は減りますか?
「定型SQL書き」は減りますが、「AIが正しく動く土台(スキーマ・メタデータ・カラム説明)を作る仕事」がむしろ増えます。スキルセットの強化でAI時代に対応するのが王道です。
Q5. 学習にはどれを試すべき?
個人学習ならChatGPT+公開サンプルDB(DVD Rentalなど)から始めるのが最速。実務想定ならVanna AI(OSS)を自分のPCで動かして、3層構造を体感するのがおすすめです。
まとめ|Text to SQLは「データ民主化」の本命技術
「SQLが書ける人だけがデータを使える」時代から「日本語で誰でも引ける」時代へ
Text to SQLは、自然言語からSQLを自動生成するAI技術で、2025〜2026年に主要ベンチマークで精度80%超に到達し、業務利用が本格化しています。「LLM+スキーマ+RAG」の3層構造で精度を高めるシステム設計が定番で、Snowflake CortexやGoogle Geminiなど主要クラウドDBが標準機能として組み込み始めました。
SQLが書けない営業・経営層もデータを直接引けるようになる一方、誤クエリ実行・セキュリティ・誤分析のリスク管理が新たな課題。読み取り専用ロール+DML制限+人間レビューの3点セットを徹底しましょう。SQLの基本を理解している人ほど恩恵を最大化できます。
関連記事として、SQL基本完全ガイド、ローカルLLM、文脈エンジニアリング、MCPと併せて読むと、AI時代のデータ活用全体像が見えてきます。
主要ツールの料金比較表
| ツール | 料金の目安 | 特徴 |
|---|---|---|
| Vanna AI | 無料(MITライセンス・OSS) | Python製フレームワーク。使うLLM・ベクトルDBを自由に選択でき、自社アプリへの組み込みに向く |
| Snowflake Cortex Analyst | エディションに関わらずメッセージ課金が発生(スタンドアロンAPIは約67クレジット/1,000メッセージ+SQL実行分の別途課金) | Snowflakeユーザーなら追加ベンダー・データ移動なしで導入可能 |
| AI2SQL | 無料プランあり/有料は月額数ドル〜 | チャット感覚でSQLを生成、非エンジニアでも扱いやすいUI |
| SQLAI.ai | 無料プランあり/有料は月額6ドル程度〜 | 複数DB接続、クエリ履歴管理などビジネスユーザー向け機能が充実 |
すでにSnowflakeを使っているチームはCortex Analystから検討するのが合理的です(追加のベンダー契約やデータ移動が不要なため)。一方、複数のLLMやベクトルDBを柔軟に選びたい、自社プロダクトに組み込みたいという場合はVanna AIのようなOSSフレームワークが向いています。
自社データで使うRAG構築の手順
自社のテーブル構造・ビジネス用語に対応したText to SQLを構築する基本手順は次の通りです。(1)スキーマ情報(テーブル定義・カラムの説明・代表的なJOIN関係)をドキュメント化する、(2)過去の代表的なSQLクエリと、それに対応する自然言語の質問例をペアで用意する、(3)これらをベクトルDB(Chroma・Pinecone等)に埋め込み、質問時に関連するスキーマ情報・類似クエリ例を検索して取得する、(4)取得した情報をプロンプトに含めてLLMにSQLを生成させる、(5)生成されたSQLを実行前に静的チェック(危険なDELETE/DROP文の検知など)にかける。Vanna AIなどのOSSフレームワークはこの一連の流れをライブラリとして提供しているため、ゼロから実装するより早く着手できます。
日本語の自然言語クエリの精度
日本語での質問精度は、英語に比べてテーブル名・カラム名が日本語と対応付けづらい(例:「売上」が複数テーブルの複数カラムに存在する等)ことが原因で、英語クエリよりやや誤りが出やすい傾向があります。精度を上げるコツとして、(1)カラムの説明を日本語で明示的にメタデータへ記述する、(2)よくある日本語の質問パターンと正解SQLのペアを多めに用意してRAGの参照精度を上げる、(3)あいまいな用語(「今期」「直近」等の期間表現)は事前にビジネスルールとして定義しておく、(4)生成後のSQLを実行前にプレビュー表示し、ユーザーが意図と合っているか確認できるUIにする、といった対策が有効です。
日本語対応が確認しやすいツールとしては、AI2SQL(日本語UIでチャット感覚のSQL生成ができる)やSQLAI.ai(日本語でのクエリ作成・複数DB接続に対応)などがあります。日本語のテーブル名・カラム名を使うスキーマでも、たとえば「受注テーブル」の「売上金額」といったカラムに日本語の説明をメタデータとして入れておけば、これらのツールはそのまま解釈してSQLを生成できます。実際に、日本語スキーマのまま運用しているチームでは、英語に置き換えたスキーマと同じ感覚で使えている例が増えています。
BIツール連携(Tableau・Power BI)の例
Text to SQLはBIツールと組み合わせることで、ダッシュボードを開かなくてもチャット感覚でデータを確認できるようになります。代表的な連携パターンは、(1)Text to SQLで生成したクエリ結果をTableau/Power BIのデータソースとして定期的に更新する、(2)Power BIの「Q&A」機能やTableauの「Ask Data」的な自然言語検索機能と併用し、複雑な集計はText to SQL側、定型ダッシュボードはBIツール側と役割分担する、(3)SlackやTeams上のチャットボットからText to SQL経由でクエリを実行し、結果をBIダッシュボードへのリンク付きで返す、といった形です。既存のBI投資を活かしながら、アドホックな質問への対応速度を上げられる点がメリットです。
セキュリティ・権限設計のベストプラクティス
Text to SQLを本番導入する際は、(1)LLMに直接本番DBへの書き込み権限を持たせず、生成したSQLは読み取り専用(SELECT文のみ)に制限する、(2)ユーザーの権限に応じた行レベル・カラムレベルのアクセス制御をDB側で設定し、LLMの生成結果に関わらず見えるデータを制限する、(3)個人情報・機密情報を含むカラムはマスキングまたはクエリ対象から除外する、(4)生成されたすべてのSQLと実行結果をログとして保存し、監査できるようにする、(5)危険なクエリ(全件取得・重い結合等)を検知してブロックするガードレールを設ける、といった設計が推奨されます。利便性とセキュリティのバランスを取るため、まず限定的なデータセット・部署から試験導入するのが現実的です。


コメント