
本記事には広告(PR)が含まれています。
「データエンジニアのキャリア戦略が知りたい?」
「未経験からのロードマップってどんな感じ?」
近年、企業のデジタル化が進むにつれて「データエンジニア」の需要は急速に高まっていると見られます。
しかし、エンジニアの中でも役割が広く、未経験の人にはイメージしづらい職種でもあります。
そこでこの記事では、データエンジニアのロードマップをわかりやすく解説します。
さらに、未経験から実務1〜3年の成長戦略、単価の相場、そしてETLや基幹システム連携といった実務のリアルまで、データエンジニアを目指すうえで知っておきたいポイントをまとめて紹介します。

データエンジニアは「やめとけ」「つまらない」と言われる5つの理由を解説。汚いデータ整理の現実、評価されにくさ、向いている人と向いていない人の特徴、年収レンジ、データサイエンティスト/アナリストとの違い、キャリアパスまで現役視点で網羅。
 キッカケエージェント |
【転職初心者向け】 ・20~30代におすすめ ・手厚い転職サポート ・優良非公開求人多数 公式サイトで無料登録する |
|---|
データエンジニアとは?

データエンジニアは、企業に散らばるデータを 集めて、整えて、使える形にする ことを専門とするエンジニアです。
販売データや顧客情報、勤怠、売上などは、システムごとに形式も仕様もバラバラで、そのままでは分析にもAIにも使えません。
そこでデータエンジニアが、データを収集し、加工し、DWHや分析基盤に流し込み、ビジネスで使える状態へ仕上げていきます。

データエンジニアは企業が「データを活用できる状態」にする交通整備屋さん、と考えるとわかりやすいです。
具体的な役割
- データパイプライン(データの流れ)の構築
- データベース設計・メンテナンス
- データ連携(ETL/ELT)
- BIツールや分析基盤へのデータ提供
- バッチ処理・スケジューラ管理
- データ品質の担保
DXが進む現代では「データを使えない状態」から「使える状態」へ移行する役割が必須となり、データエンジニアの価値はより高まっています。
データエンジニアはなぜ必要なのか
システムはもともと分析用途ではなく、「販売管理」「勤怠」「給与」「会員サイト」など、別々の目的で作られています。
DXだ、データ活用だと言われますが、現場でよくぶつかるのは「まともに使えるデータがない問題」 です。
- データがそもそも存在しない
- どこに何があるか整理されていない
- 欠損・重複・不整合だらけで、まともに使えない
そのため、データを横断して分析できる状態に整えるには、技術的な橋渡し(データ基盤づくり)が必要 です。
「データエンジニアにおすすめの本は?」 データエンジニアリングは、クラウド・ETL・データ品質・モデリング・MLOps など守備範囲が広く、体系的に学ぶには良書選びが非常に重要です。 信頼できる書籍は、現場で培われた知見や考え方を短時間で吸収でき、独学では見落としがちな視点も補っ…
データエンジニアと他職種の違い

| 比較対象 | 役割・仕事内容 | データエンジニアとの違い |
|---|---|---|
| バックエンドエンジニア | Webアプリの機能を作る(API開発、業務ロジック実装) | データエンジニアは「機能」ではなく、データの流れ・変換・連携を設計し、安定稼働させることに集中する |
| インフラエンジニア | サーバー、ネットワーク、OS、コンテナなどシステムが動く基盤を作る | データエンジニアは、サーバー上で動くデータ基盤(ETL、DWH、パイプライン)を設計・運用する |
| データサイエンティスト | 統計・機械学習・AIでデータを解析し、モデルやインサイトを作る | データエンジニアは、解析できるようにキレイで扱いやすいデータを用意する(前処理・パイプライン構築など) |
バックエンドは機能そのものを作る職種であり、インフラはシステムを動かす土台を整える職種です。それに対してデータエンジニアは、データそのものの流れと構造を設計する仕事 です。
また、データサイエンティストが分析を行うのに対し、その分析に耐えるデータを用意するのがデータエンジニアです。
データサイエンティストとデータエンジニアの違いを一言で整理。DEは「基盤を作る」、DSは「価値を引き出す」役割です。MLエンジニア・データアナリストも含めた4職種を役割・年収・必要スキル・向いてる人で比較し、どの道を選ぶべきか解説します。
データエンジニアが扱う技術領域

SQL
SQLで求められるスキル:
- 差分管理(更新/削除/新規)
- 正規化・非正規化の判断
- 大量データのパフォーマンスチューニング
- DWH設計(スタースキーマなど)
実務の大半はSQLが占めると言われることがあります(比喩・目安)。
レベルがあがるにつれて、SQLの文法だけではなく実行スピード(パフォーマンス)やバックアップ処理、リカバリー処理などインフラよりの知識も求められます。
ETL/データ連携
代表的なETLツール:
- Informatica
- Talend
- AWS Glue
- Dataform(Google Cloud/BigQuery)
- Azure Data Factory
- Pentaho
ETLツールは、企業間・システム間のデータ連携を担います。
システムによって文字数が異なる、そもそも対応する項目が存在しないなどの不整合をETLツールを用いて補正します。
「データを吸い上げる → 加工する → DWHへ流す」というデータのパイプライン(流れ)を自動化します。
データエンジニアはSQLが書けて、ETLでパイプラインを組めると一気に市場価値が上がります。
クラウド(GCP / AWS)
クラウドの例:
- BigQuery / Redshift / Snowflake
- Cloud Composer / StepFunctions
- GCS / S3
- Lambda / CloudFunctions
- Airflow
クラウドは「一度触れば理解が深まる」ため、現場アサインされた後に実務経験で勝手に育つ領域です。

データエンジニアにおすすめの資格10選を、レベル別・難易度・年収アップ効果別に解説。基本情報技術者・ORACLE MASTER・AWS・Python・統計検定・G検定・Tableauなど、未経験から取るべき順番と勉強法まで2026年版で網羅。
未経験から実務3年までのロードマップ
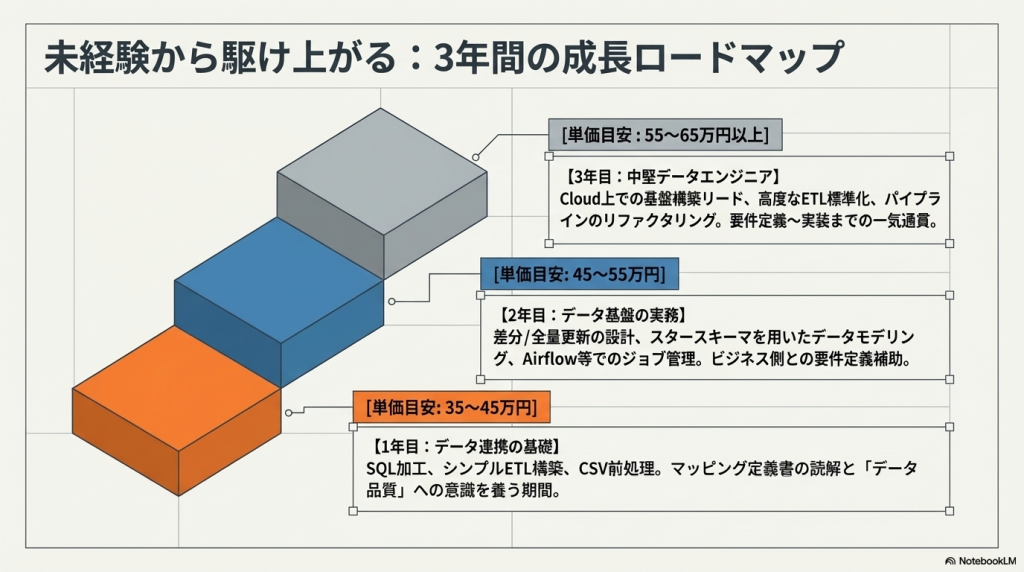
1年目:データ連携の基礎
- SQLを使ったデータ加工
- ETLツールでシンプルなパイプライン構築
- CSVの前処理・チェック
- 基幹システムのデータ理解
- バッチ処理の運用保守
- データマッピング定義書の読み書き
1年目では、データエンジニアリングの基礎となる「データを正しく扱う力」を身につけることが中心となります。
主な業務は、SQLを使った抽出・加工処理、ETLツールによるシンプルなパイプライン構築、CSVの前処理や項目チェックなどです。
また、基幹システムのデータ構造を理解し、日々のバッチ処理の運用保守に触れることで、データの流れや品質の考え方が身につきます。
特に、1年目の段階でデータ品質に対する意識(NULLチェック・文字種統一・整合性確認)が自然と身につく人は伸びやすい傾向があります。
マッピング定義書を正しく読み書きできるようになることも、この時期の大きな成長点です。単価としては60万前後が目安とされます(2026年時点の実勢・案件・スキルで変動)。
2年目:データ基盤の実務
- 差分更新/全量更新の設計
- データモデリング(スタースキーマなど)
- DWH/データレイク構築
- ジョブ管理(Airflow/DS Scheduler など)
- エラー通知・ログ監視
- 複数部署と連携しての要件定義補助
2年目に入ると、より応用的なデータ処理を担当する機会が増えます。
差分更新・全量更新など方式設計、スタースキーマを用いたデータモデリング、DWH・データレイクの構築といった「基盤側の実務」に踏み込みます。
また、Airflow や DS Scheduler などのジョブ管理ツールでパイプラインの運行設計を行い、エラー通知やログ監視といった運用面も任されるようになります。
2年目の段階では一人称の作業は難しくとも要件定義の補助、複数部署と連携やデータの仕様調整に参加したりと、ビジネス側とのコミュニケーションも重要になります。単価としては60〜70万が目安とされます(2026年時点の実勢・案件・スキルで変動)。

データエンジニアの将来性を徹底解説。AI・データ活用時代に需要が伸びている理由、年収相場、転職市場と難易度、未経験からの転職方法、必要スキル、キャリアパスまでまとめます。
3年目:中堅データエンジニア
- Cloud上で基盤構築をリード
- 高難度ETL(条件分岐・差分管理の標準化)
- パイプラインのリファクタ
- BIレイヤの最適化
- データ品質管理の仕組み構築
- 要件定義〜設計〜実装の一気通貫
3年目以降は、クラウド環境での基盤構築や高度なETL処理など、より広い範囲をリードしていく段階です。
条件分岐や差分管理の標準化、パイプラインのリファクタリング、BIレイヤの最適化などを通じて、データ基盤全体の品質と効率を高める役割が期待されます。
また、要件定義〜設計〜実装までの一連のプロセスを一気通貫で担当できるようになれば、いわゆる「中堅〜上級データエンジニア」の位置付けになります。
3年目は個人差が大きくなりますが、単価70〜90万が想定される場合があります(2026年時点の実勢・案件・スキルで変動)。

データエンジニアの年収を年代別(20〜50代)・スキルレベル別・企業規模別・地域別に解説。フリーランス単価、外資/SIer/事業会社の比較、年収アップする5つの方法、年収交渉術、未経験から目指すロードマップまで2026年最新版で網羅。
データエンジニアリングのライフサイクル

データ収集
まず、分析対象となるデータがどこで生まれているのかを把握します。
代表的なソースとして、自社サービスのDB、Salesforce などの SaaS、外部API・センサーからのデータ、Excel/CSV といった非構造データの4種類があります。
それぞれ管理方法や仕様が異なるため、「バラバラなデータをどうやって揃えるか」が最初の課題となります。
データ加工・統合
運用DB(RDB)はトランザクション処理向け、DWHは大量データの高速分析向けです。近年はDWHの性能向上により、ELT(先にロードしてDWH側でSQL加工) が主流になっています。
加工設計では、
Lake(生データ)→ DWH(再利用可能な整形)→ Mart(用途特化)
という3層構造(+stg層)がよく使われます。
また、パイプラインでは 冪等性(何度実行しても結果が同じ) が重要で、差分更新まで設計できると、中級以上のデータエンジニアと評価されます。
データ活用・分析
整形されたデータは、分析・BI、機械学習向けの学習データ、リバースETL(DWH→SaaSへの戻し)などで活用されます。
スコアリング結果をMAツールに戻して施策に反映するなど、ビジネス価値を生む工程です。
キッカケエージェント |
【転職初心者向け】 ・20~30代におすすめ ・手厚い転職サポート ・優良非公開求人多数 公式サイトで無料登録する |
|---|

データエンジニアの実務の具体例

実際の現場でよくある仕事(受信したファイルとマスタデータの差分を比較し、差異があるデータに関して警告エラーを出し、メールで報告するインターフェイスの仕様)の一例です。
マッピング定義書の整備
- 入出力一覧
- 更新キー
- 差分処理の方針
- エラー出力仕様
データ連携の準備では、まず入出力の項目が正しく対応しているかを整理します。CSVに含まれる項目と、連携先のテーブルのカラムをどのように紐付けるかを決め、データ型や桁数、必須項目などの基本仕様を明確にします。
さらに、データを比較するための更新キーを定義し、どの条件で新規や更新と判断するかを最初に決めておきます。
また、異常があった場合にどのようなメッセージを出し、どこへ知らせるのかといったエラー仕様も、この段階でまとめます。
マッピング定義書は後続の処理すべての基準になるため、丁寧に作ることが重要です。
CSVを一時テーブルに格納から加工
- NULLチェック
- 文字種(カナ)統一
- 日付の正規化
- コード値の変換
受信したCSVはそのまま使わず、一度一時テーブルに取り込みます。取り込んだ後にデータ品質を整えるため、NULLの確認や文字の揺れを直す処理、日付のフォーマットを正しく変換する処理などを行います。
人事関連のデータでは、文字種が混ざっていたり、日付が不正な形式で入っていることがよくあるため、ここで整えることが欠かせません。
また、ファイルだけでは不足する情報が多いため、社員マスタや家族マスタを参照して必要な情報を補完します。
正しく比較できるデータの状態にしてから次の工程へ進みます。
マスタ情報とJOINして不足データを補完
外部システムから送られてくるデータには必要な情報がすべて揃っていないことが多いため、マスタデータを参照して補完します。
社員IDだけが渡される場合は社員マスタを参照して部署や雇用情報を取得し、家族情報であれば家族マスタから続柄や生年月日を取得します。
必要に応じて、配偶者区分や保険区分などの情報も関連マスタから取得して、最終的に連携先が求める形に整えます。
業務知識が必要になる部分であり、データエンジニアの理解度が特に現れる工程です。
差分抽出
- 新規
- 更新
- 削除
整えた今回データと、既に登録されている前回データを比較し、新規なのか、値が変わっている更新なのか、今回データには存在しない削除対象なのかを判定します。
社員IDや家族IDなどのキーを使い、項目のどこかに変化があれば更新とし、前回データだけに存在する場合は削除と判断します。
この差分の判断が正しくできないと、意図しないデータの残り込みや重複が発生してしまうため、慎重な設計が求められます。ここができると一気に実務経験者として評価されやすくなります。
エラーのログ化・メール通知
処理をする中で発生したエラーはすべて記録し、どのデータの何が問題だったのかを明確に残します。
必須項目の欠落や不正値、マスタに存在しないIDなど、あらゆる異常を検知し、ログとともに関係者へメールで通知します。
処理件数やエラー件数などをまとめて送ることで、運用担当者が毎日データの異常に気づける仕組みを作ります。
基幹システムでは特に、異常を確実に知らせる仕組みが重要視されます。
データエンジニアは「やめとけ」「つまらない」と言われる5つの理由を解説。汚いデータ整理の現実、評価されにくさ、向いている人と向いていない人の特徴、年収レンジ、データサイエンティスト/アナリストとの違い、キャリアパスまで現役視点で網羅。
未経験からデータエンジニアになるには?
データエンジニアの必要スキル
- SQL(最重要)
- ETL/データ連携の経験
- クラウド(BigQuery/Redshiftなど)
- データモデリング
- バッチ・スケジューラ
最優先で習得すべきはSQLです。そのうえで、実際にETLツールを触ってデータを流してみる経験を積むと、データ基盤の全体像が掴みやすくなります。
「SQL × ETL」があれば十分市場に出られます。
データエンジニアに必要なスキルセットを完全網羅。SQL/Python/クラウド/分散処理などのハードスキル、ソフトスキル、おすすめ資格、習得の優先順位と学習ロードマップ、未経験からの勉強法までまとめます。
まとめ:データエンジニアの未来は明るい

データ活用は今後も伸びていくと見られる領域であり、年齢制限も比較的ゆるいと言われることがあります(将来予測・目安)。
未経験からでも、1〜2年で市場価値をつけていくケースもあるとされます(目安)。SQLとETLを軸に成長すれば単価70万〜80万も現実的になる場合があります(案件・スキルで変動)。
「データを扱えるエンジニア」は、これからの時代において確実に強い武器となります。
データエンジニアのロードマップに関するよくある質問(FAQ)
データエンジニアになるまでどのくらいの期間がかかりますか?
完全未経験から転職成功まで1〜2年程度かかるケースが多いとされます(目安)。ITエンジニアの経験がある方(インフラ・バックエンド等)であれば6ヶ月〜1年程度でスキルを補完して転向できるケースもあるとされます。学習時間の確保が鍵で、週20時間以上の学習が推奨される場合があるとされます(目安・環境により変動)。
ロードマップの中で最初に学ぶべきは何ですか?
SQL(SELECT・JOIN・ウィンドウ関数)が最優先です。データエンジニアの日常業務の大半はSQLを中心に展開されます。次にPython基礎(pandas・requests等)、Linuxコマンド基礎の順で学ぶと効率的です。クラウド(AWS/GCP)は基礎固め後に学ぶとより理解が深まります。
独学とスクールのどちらがおすすめですか?
自走力があり時間を確保できる方は独学、転職サポートや体系的な学習環境が必要な方はスクールがおすすめです。独学ではUdemy・Coursera・公式ドキュメントを活用し、Kaggleや個人プロジェクトでポートフォリオを作成します。スクールはWeb系中心でデータ/AI系コースを持つ場合があります(例:DMM WEBCAMP公式にデータサイエンスコース)。
次に読むべき記事
ロードマップを確認した後は、具体的なスキルや資格について詳しく調べてみましょう。
AI実装スキルを磨きたい人へ
これからのAI時代に 「市場価値の高い人材」 とは、「モデルを使える人」ではなく 「業務に組み込んで価値を出せる人」 です。AI実装+エンジニアリング+業務理解の三点セットを磨くことが、5年後・10年後のキャリアに直結します。
※以下、PRを含みます


コメント